KREA2で画風LoRAをつくってみる
環境:Musubi Tuner / RTX PRO 5000 Blackwell / Claude Code (Fable 5)
Krea 2で画風LoRAをつくってみました。学習素材には自分の絵を使っています。絵の学習はなかなか繊細なトピックですが、自分の絵なら問題にならないだろうと思いました。
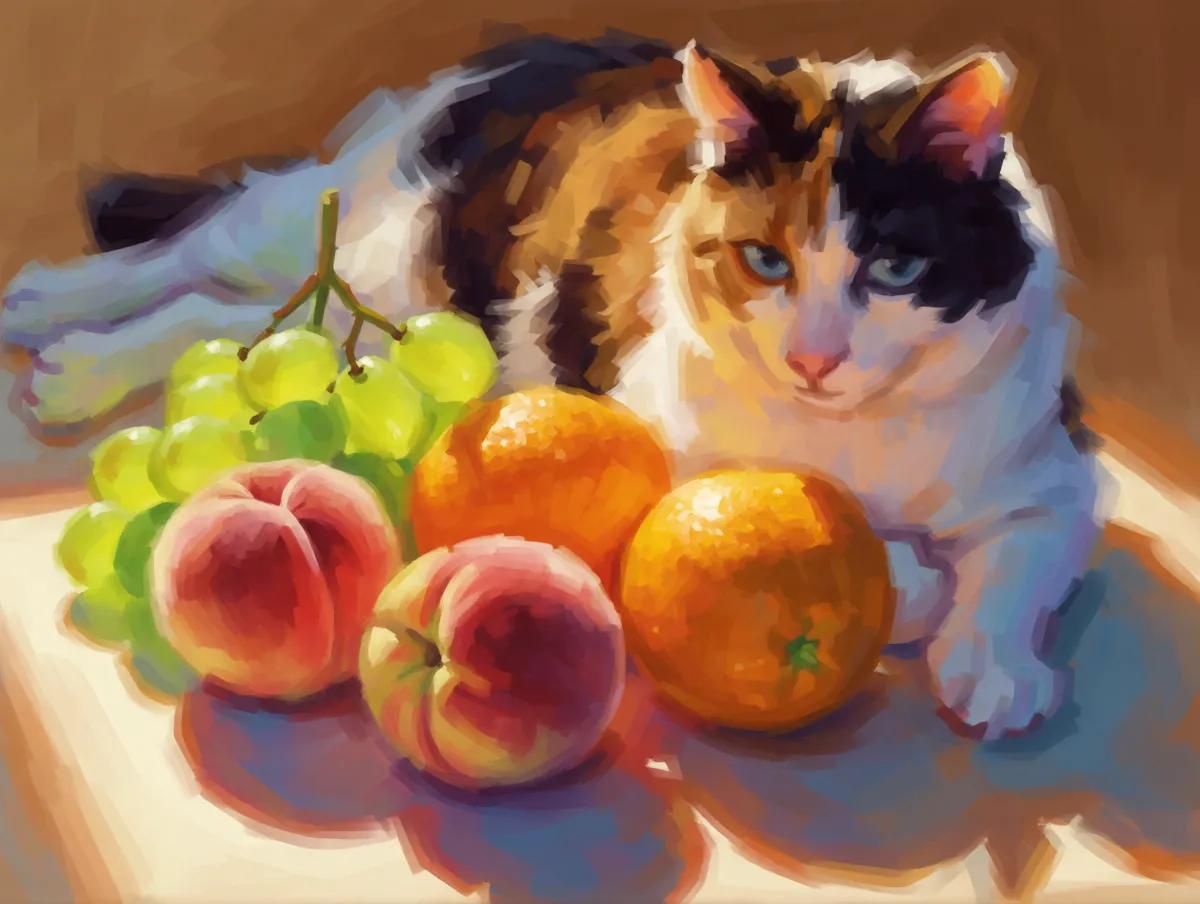
LoRAを当てて生成した絵。本当に自分が描きそうな描き方で驚きます。
Krea 2について
アメリカのKrea AIが2026年6月22日にウェイトを公開した画像生成AI。
| 正式名 | Krea 2(Krea 2 Raw / Krea 2 Turbo) |
|---|---|
| 公開日 | 2026年6月22日(オープンウェイト公開) |
| 開発会社 | Krea.ai, Inc.(アメリカ) |
| ライセンス | Krea 2 Community License(年商100万ドル未満は商用可) |
| モデル規模 | 129億パラメータ(12.9B) |
| アーキテクチャ | single-stream DiT / 28ブロック・幅6144 |
| テキストエンコーダ | Qwen3-VL-4B-Instruct(中間12層をまとめて使う) |
| VAE | Qwen-Image VAE |
| 出力 | 1K〜2K(学習は256→512→1024pxと段階的) |
| 検閲 | フィルタは配布物に含まれない(実装側で用意する前提) |
RawとTurboの2つが同時に出ていて、未蒸留のRawで学習し、蒸留済みのTurboで描く、という分担が最初から設計に入っているのがこのモデルの特徴。LoRAをつくる話とは相性がよいらしい。
画風LoRAを作ることにしたきっかけ
画風LoRAを作ろうと思った理由は、大きく2つあります。
ひとつは、Stable Diffusionなどの少し古くなってきたモデルの画風を保存し、今どきのモデルでもその絵柄を再現したいと思ったことです。Stable Diffusion世代ではタグを並べるタイプのプロンプトが中心で、描画表現にも限界があります。そろそろ文脈で指示を書くタイプのプロンプトで絵を描きたいのですが、自分の好きな画風を再現できるモデルがまだありません。
もうひとつは、単純に「自分の絵を学習させて絵を描かせてみたら面白そう」という興味からです。描いた本人だからこそわかることもありそう。
Musubi TunerをLoRA学習に使う
学習にはMusubi Tunerを使いました。ただし直接叩くのではなく、Claude Codeを介して利用する形にしました。Claude CodeにアプリのGUIを作ってもらい、そこからクローンしたMusubi Tunerを実行する、という流れ。なんども試行錯誤をするうえで、差分を確認するために、アセット管理の仕組みは自前で作成しておきたかったのでした。
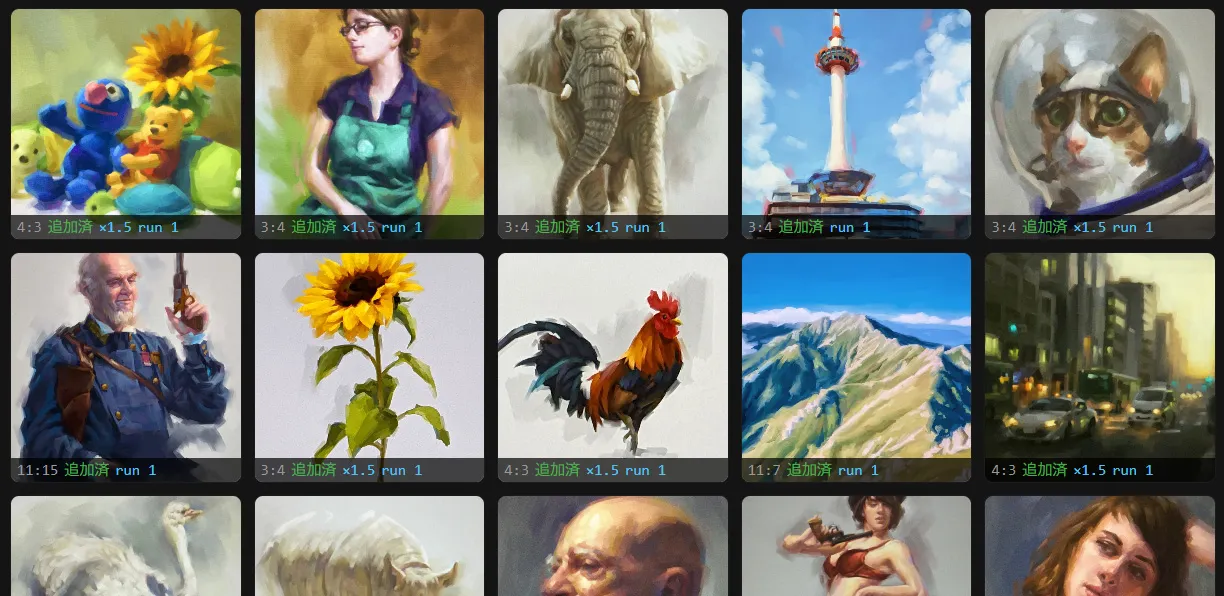
学習させた絵は40枚。過去に描いた絵からランダムに選び、人物、風景、動物、静物とバランスよく揃えた。
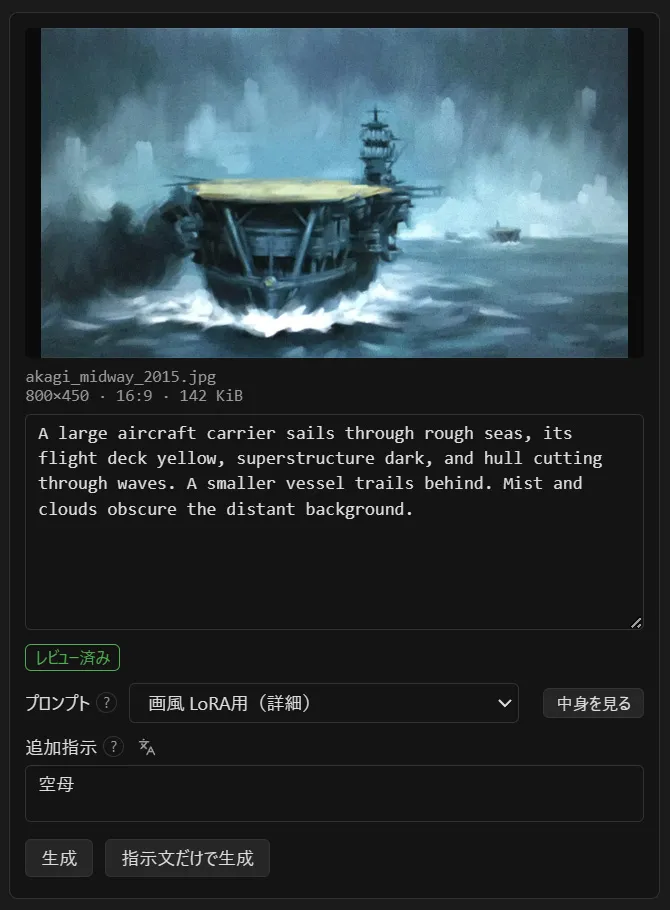
各画像にはキャプションをつける。画風LoRAのキャプションは絵に描かれているものだけを記述し、画風については書かない、ということが大事。キャプションの生成にはLLMの視覚モデルを使い、Qwen3.8 27Bが詳細に読み取ってくれたので、これを既定のモデルとした。視覚モデルでも読み取れない情報は、追加指示のテキストを別に設けて、それを参考にキャプションを生成させるようにした。
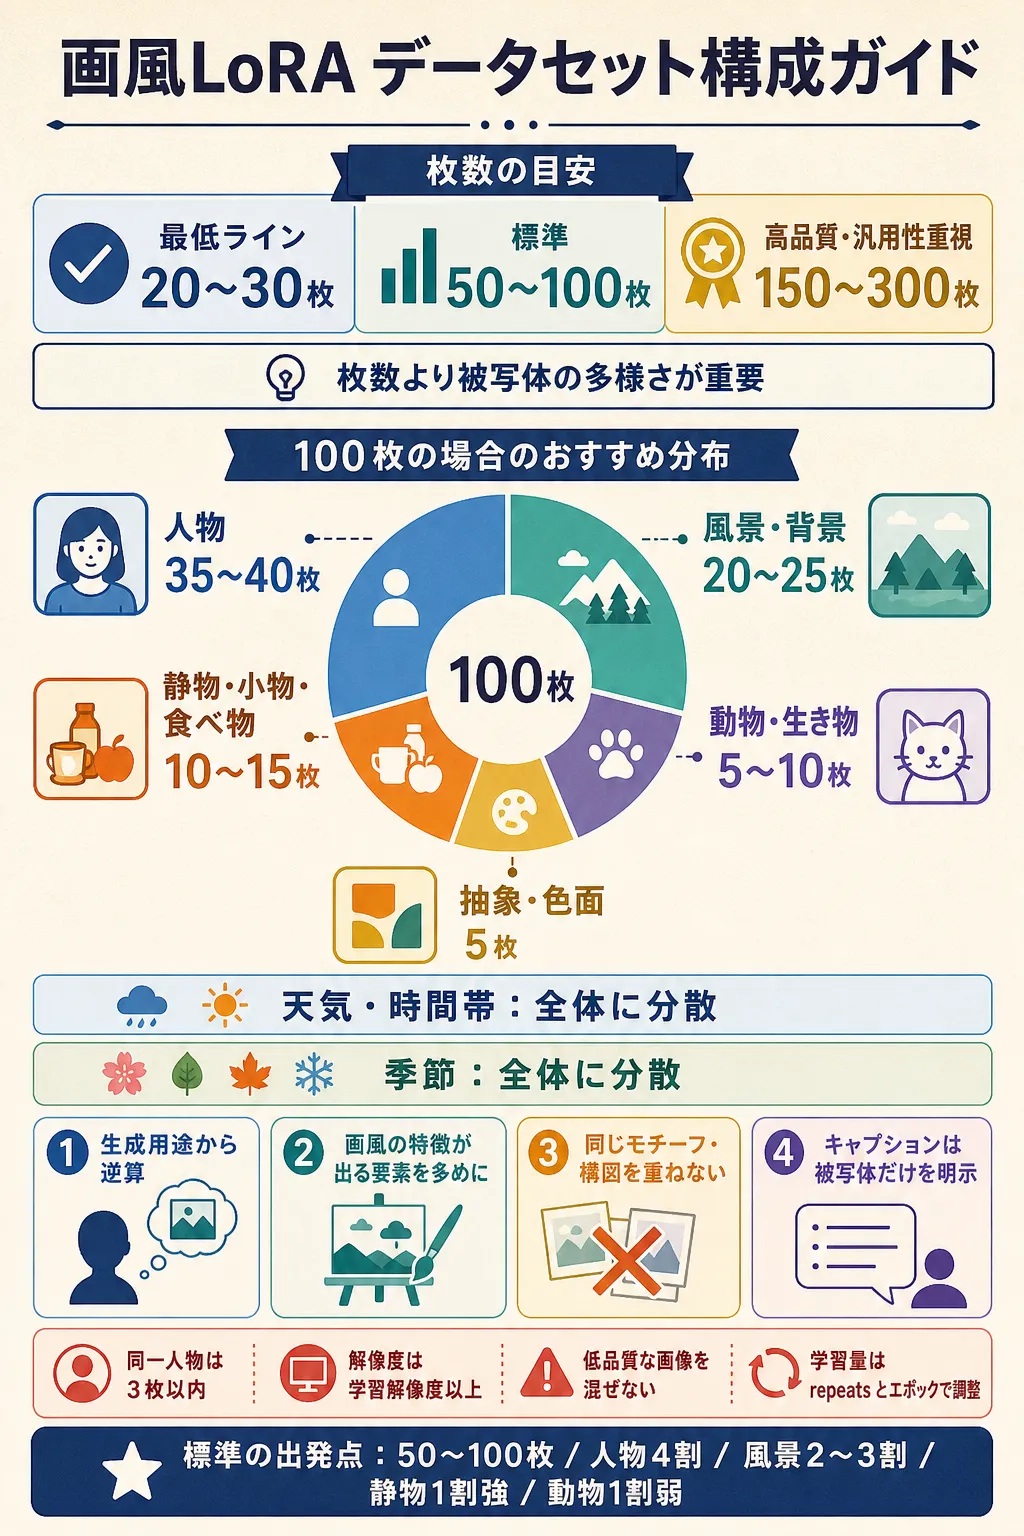
学習過程
RTX PRO 5000 Blackwellで約1時間。40枚を1周して40ステップ、それを16エポック回すので 40 x 16 = 640ステップの計算になる。
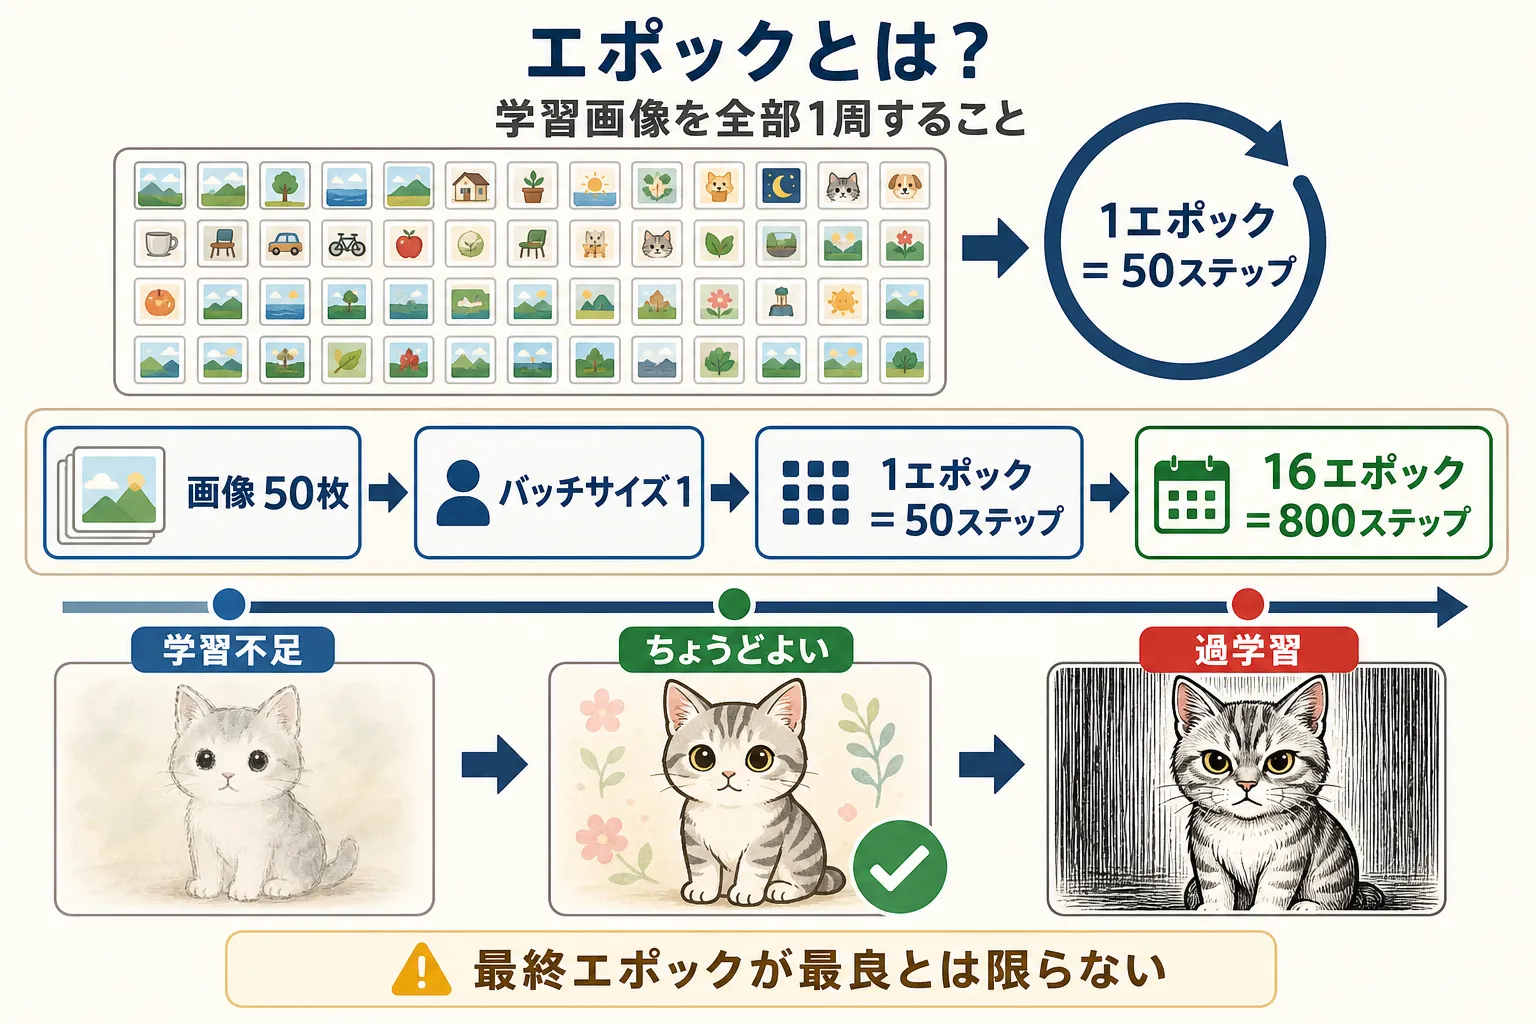
1ステップで行われているのは、おおよそ次の流れ。
- 画像を1枚(バッチサイズ1なら1枚)取り出し、VAEで潜在表現にする。キャプションはQwen3-VLでテキスト埋め込みにする
- 潜在表現にランダムな強さのノイズを乗せる
- ノイズ入りの潜在表現とキャプションをKrea 2 Rawに渡し、「乗せたノイズ」を予測させる
- 予測と実際のノイズの差(loss)を計算する
- 差が小さくなる方向へLoRAの重みだけを少し更新する。本体の129億パラメータは動かさない
モデル本体は凍結し、LoRAという小さな追加分だけを640回にわたって少しずつ調整している、というのが学習の正体。1と2の潜在表現・埋め込みは毎回計算し直すと重いので、Musubi Tunerでは学習前にまとめてキャッシュしておく。
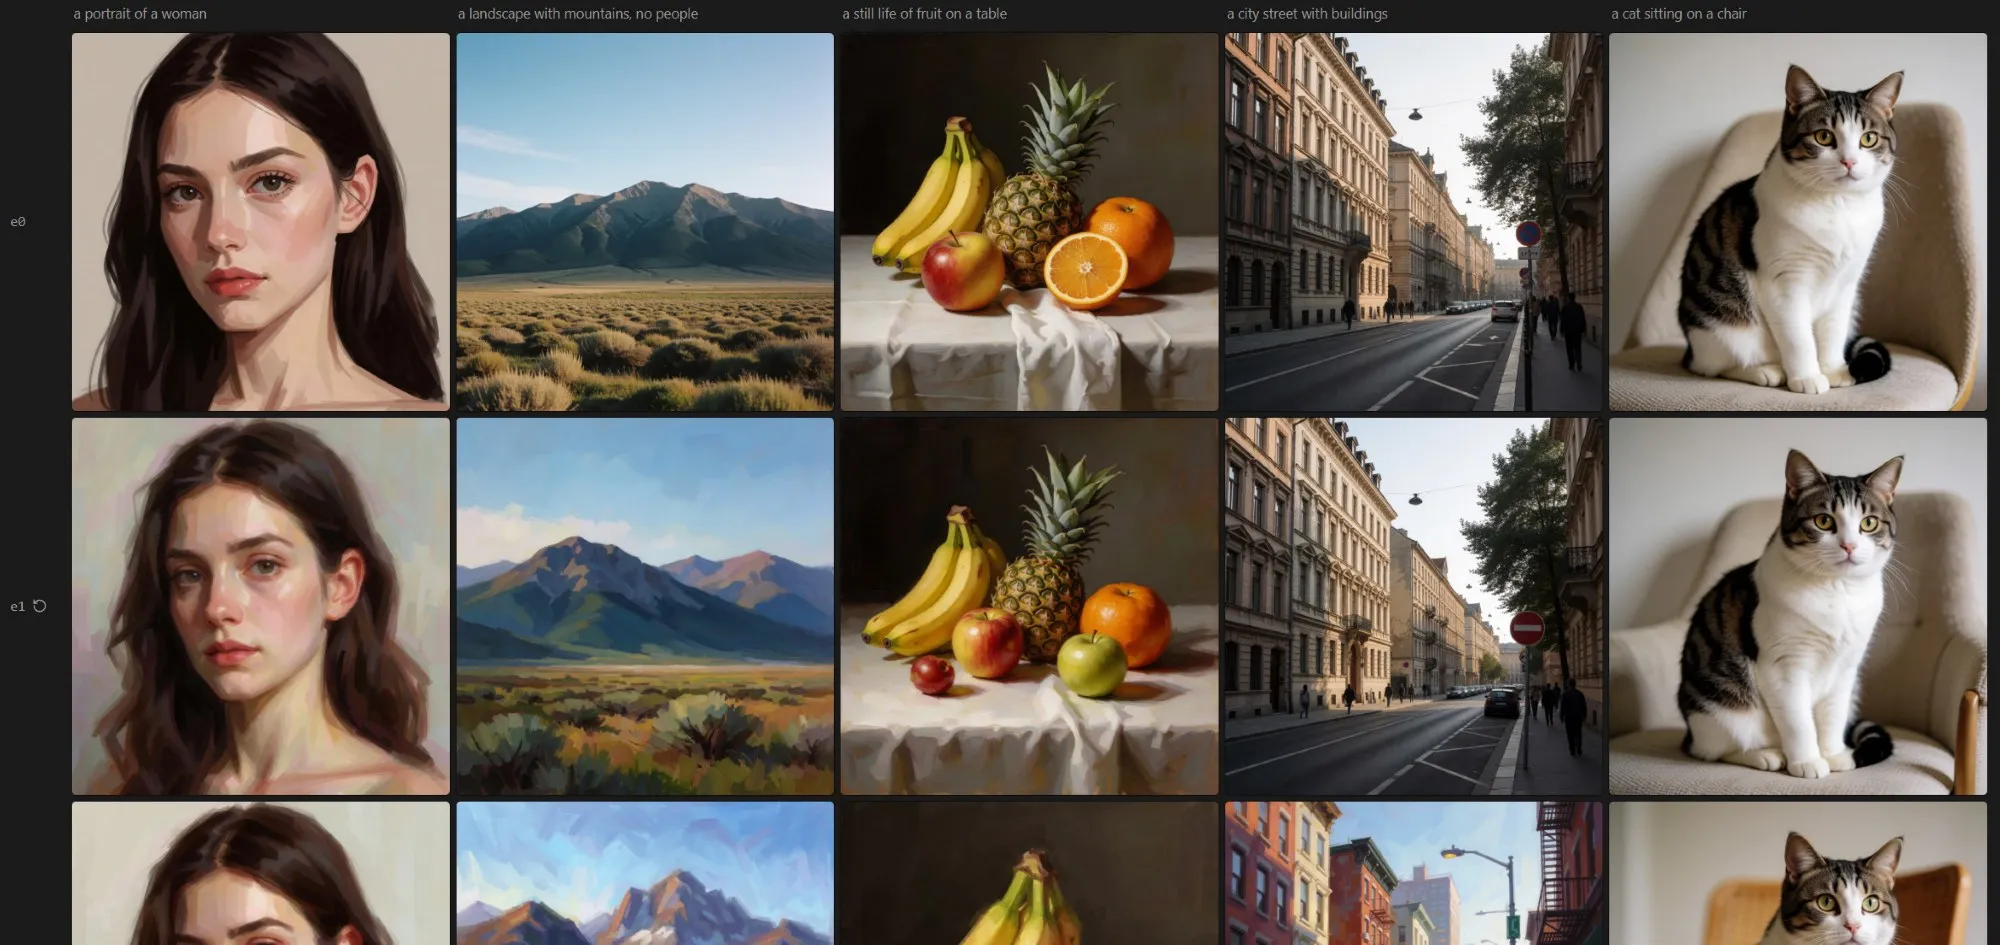
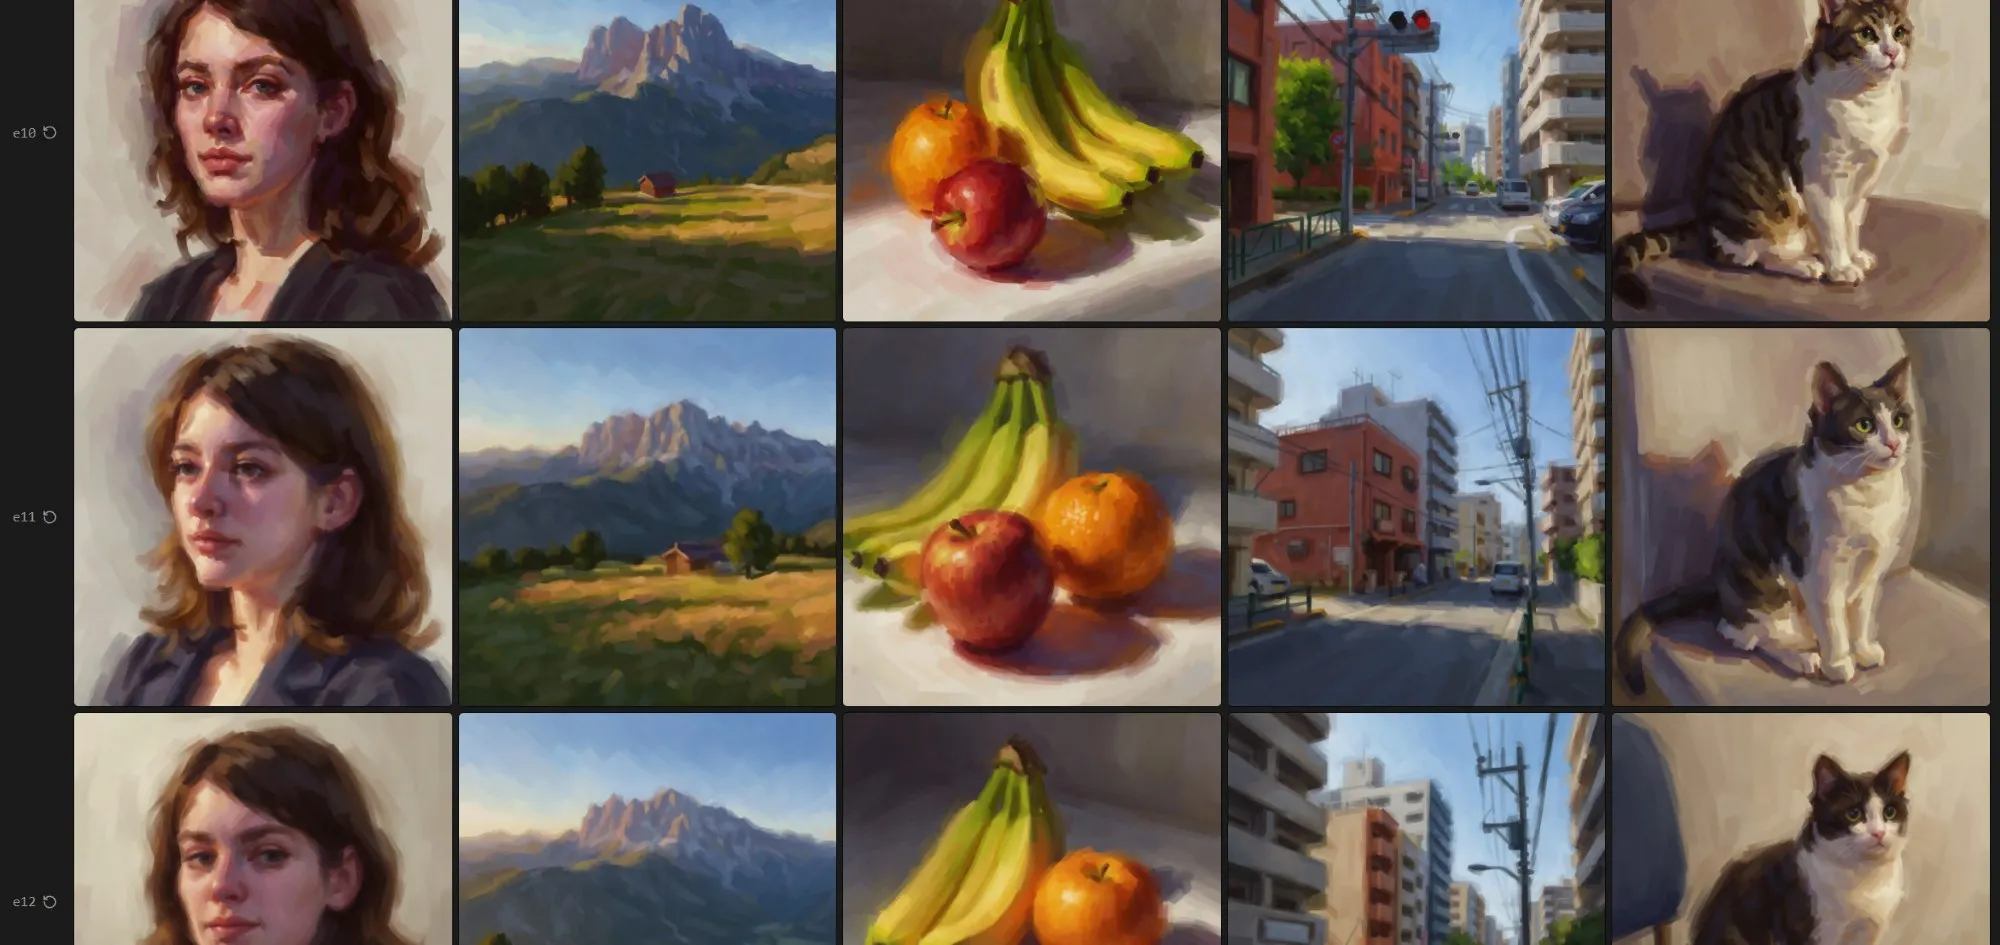
最初はモデルが元から持っている絵柄が出てくるのですが、エポックを経るごとにどんどん絵柄が変わっていく過程を見ているのは面白いです。
生成してみる
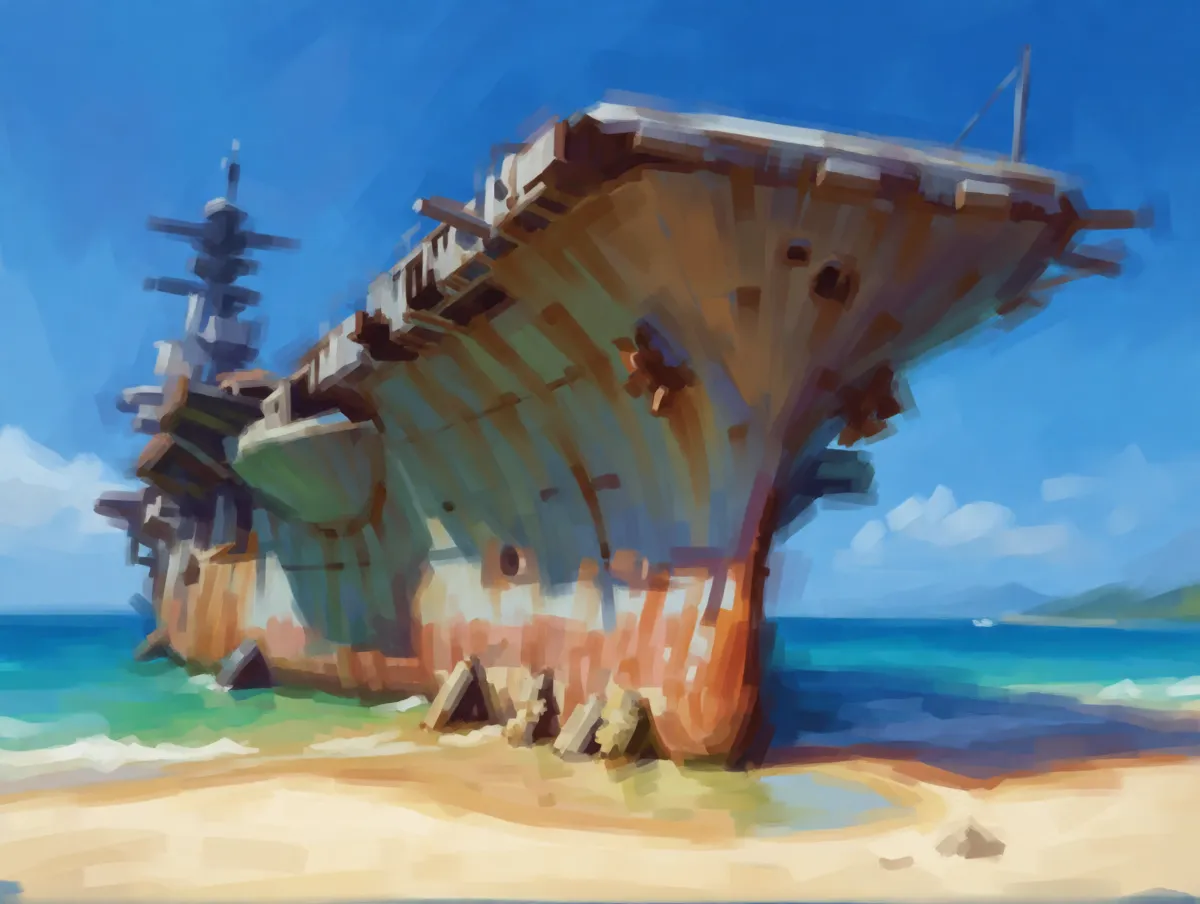
できあがったLoRAを当てて描画すると、自分の癖を覚えた描き方をしていて感心しました。ライティングの考え方(反射光や暖色・寒色)がそのまま出ていて驚きます。ちょっと全体的にメリハリがなくぬるい感じもしますが、下手なストロークもそっくり再現されており、本当にこんな絵を描きそうです。
感想
なんだか期待以上の結果でした。実は平行してQwen Imageでも試したのですが、Krea2のほうが素直な結果がでました。絵画やイラストに合っているのもありそうですね。
生成AIが出てきてから、もう絵は描きたくない気持ちになっていましたが、学習させるためにもっと上手い絵を描きたいモチベーションが少しだけ芽生えてきました。笑